robots.txt 與 Meta Robots 完整教學
robots.txt 是一個純文字檔案,放在網站的根目錄下,用來告訴搜尋引擎爬蟲:「哪些目錄或頁面你不要爬」。它是爬蟲造訪網站時第一個讀取的檔案,也是控制 crawl budget 的第一道關卡。
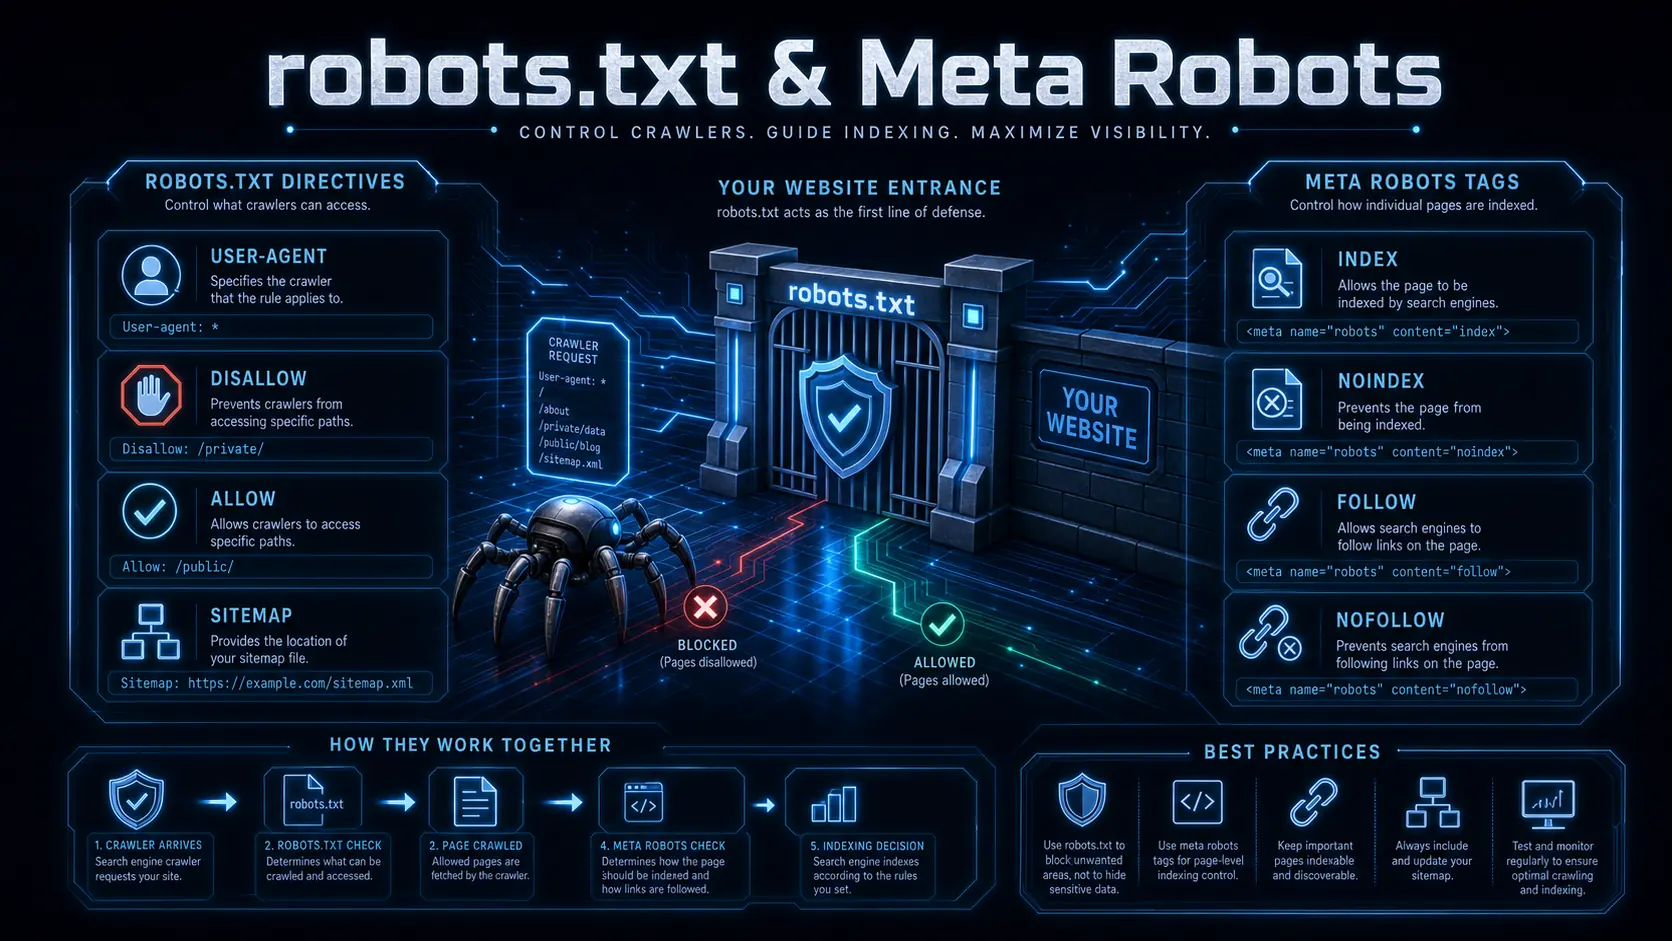
robots.txt 是什麼?
robots.txt 是一個純文字檔案,放在網站的根目錄下,用來告訴搜尋引擎爬蟲:「哪些目錄或頁面你不要爬」。它是爬蟲造訪網站時第一個讀取的檔案,也是控制 crawl budget 的第一道關卡。
https://www.hkseostore.com.hk/robots.txt
唔理你係旺角嘅樓上舖餐厅、中環嘅會計師樓,定係一間做全港生意嘅網店,只要個網站喺線上,爬蟲第一件事就係搵你個 robots.txt。
關鍵觀念: robots.txt 是「禁止爬取」的指令,不是「禁止索引」。頁面可能仍會透過外部連結被 Google 索引(但不爬取就無法讀取內容)。
robots.txt 基本語法
User-agent: *              # 適用於所有爬蟲
Disallow: /admin/          # 禁止爬取 /admin/ 目錄
Disallow: /private-page    # 禁止爬取特定頁面
Allow: /admin/public/      # 例外允許(子目錄)
Sitemap: https://www.hkseostore.com.hk/sitemap.xml
核心指令說明
| 指令 | 說明 | 範例 |
|---|---|---|
User-agent |
指定適用的爬蟲(* 代表全部) | User-agent: Googlebot |
Disallow |
禁止爬取的路徑 | Disallow: /wp-admin/ |
Allow |
允許爬取的路徑(用於例外) | Allow: /blog/public/ |
Sitemap |
指定 Sitemap 位置 | Sitemap: https://www.hkseostore.com.hk/sitemap.xml |
Crawl-delay |
爬取延遲(秒),部分爬蟲支援 | Crawl-delay: 10 |
注意: Googlebot 不支援
Crawl-delay,但 Bingbot 和 Yandex 支援。控制 Google 爬取速度需透過 Search Console 的「爬取速度設定」。香港提醒: 香港有 ~3-5% 用家靠 Bing(Edge / Windows 預設),而 Yahoo 香港(hk.yahoo.com)嘅搜尋結果其實都係用 Bing 技術。所以
Crawl-delay對呢批流量係有效嘅,設定時唔好忽略 Bingbot。
robots.txt 實戰範例
範例一:基礎 WordPress 網站(香港中小企最常見)
User-agent: *
Disallow: /wp-admin/
Disallow: /wp-includes/
Disallow: /wp-content/plugins/
Disallow: /wp-content/themes/
Allow: /wp-content/uploads/
Sitemap: https://www.hkseostore.com.hk/sitemap_index.xml
範例二:香港網店(SHOPLINE / WooCommerce / Shopify)
User-agent: *
Disallow: /cart
Disallow: /checkout
Disallow: /my-account
Disallow: /search
Disallow: /wishlist
Disallow: /*?*                    # 禁止所有帶參數的 URL(例如 ?utm_source=facebook)
Allow: /*?p=                      # 允許產品參數
Sitemap: https://www.hkseostore.com.hk/sitemap.xml
香港場景: 香港網店常見嘅「分店篩選」(例如
?store=銅鑼灣?store=沙田)或者「貨幣切換」(?currency=hkd)好易產生大量重複 URL,呢啲正正就係要用Disallow: /*?*擋住嘅位置。
範例三:阻止特定爬蟲
# 阻止 AI 訓練爬蟲
User-agent: GPTBot
Disallow: /

User-agent: CCBot
Disallow: /

# 其他爬蟲正常
User-agent: *
Disallow: /private/
Sitemap: https://www.hkseostore.com.hk/sitemap.xml
範例四:開發 / 測試環境(staging)
# 完全阻止所有爬蟲(適合 staging 環境)
User-agent: *
Disallow: /
香港實務: 好多香港公司會用
staging.hkseostore.com.hk或者hkseostore.com.hk/staging/做測試。記得呢個環境要同時做兩件事:①Disallow: /;② 加 HTTP 密碼保護(Basic Auth)。淨係靠 robots.txt,萬一有人 external link 過去,Google 都可能有機會收錄。
Meta Robots 標籤:頁面級別控制
如果 robots.txt 是「全站層級」的控制,Meta Robots 就是「頁面級別」的精細控制。它放在 HTML 的 <head> 區塊內:
<meta name="robots" content="noindex, nofollow">
常用指令組合
| 指令 | HTML 語法 | 說明 |
|---|---|---|
noindex |
<meta name="robots" content="noindex"> |
不索引此頁面,不讓它出現在搜尋結果中 |
nofollow |
<meta name="robots" content="nofollow"> |
不追蹤此頁面上的所有連結 |
noindex, nofollow |
<meta name="robots" content="noindex, nofollow"> |
不索引 + 不追蹤連結 |
index, follow |
<meta name="robots" content="index, follow"> |
預設值(可省略) |
noarchive |
<meta name="robots" content="noarchive"> |
不要顯示頁庫存檔(快取) |
nosnippet |
<meta name="robots" content="nosnippet"> |
不要在搜尋結果中顯示摘要文字 |
max-snippet |
<meta name="robots" content="max-snippet:150"> |
限制摘要文字長度(字元) |
max-image-preview |
<meta name="robots" content="max-image-preview:large"> |
控制圖片預覽大小 |
notranslate |
<meta name="robots" content="notranslate"> |
不要提供翻譯連結 |
針對特定爬蟲
<!-- 只針對 Googlebot -->
<meta name="googlebot" content="noindex">

<!-- 只針對 Google 新聞 -->
<meta name="googlebot-news" content="noindex">

<!-- 只針對 Bingbot(Yahoo 香港搜尋都係用 Bing 索引,擋得 Bing 即係兩個都冇) -->
<meta name="bingbot" content="noindex">
X-Robots-Tag:HTTP Header 級別控制
當你需要對非 HTML 檔案(如 PDF、圖片、Word 文件)設定索引規則時,可以在 HTTP Response Header 中加入:
X-Robots-Tag: noindex, nofollow
這對於控制以下類型檔案的索引特別有用:
- PDF 文件(例如香港公司嘅價目表、年報、學校通告)
- 圖片檔案
- 影片檔案
- JSON / API 回應
- 任何非 HTML 的資源
robots.txt vs Meta Robots vs X-Robots-Tag:何時用哪個?
| 情境 | 使用工具 | 原因 |
|---|---|---|
| 阻止爬取整個目錄(如後台) | robots.txt | 全站層級,減少 crawl budget 浪費 |
| 阻止特定頁面出現在搜尋結果 | Meta Robots noindex | 頁面級別精準控制 |
| 阻止 PDF 被索引 | X-Robots-Tag | PDF 無法使用 HTML meta 標籤 |
| 保護敏感內容不被看到 | 不要用 robots.txt | robots.txt 是公開檔案,反而暴露路徑 |
| 阻止搜尋結果顯示快取 | Meta Robots noarchive | 直接指定行為 |
| 阻止特定爬蟲(如 AI 訓練) | robots.txt | 簡單高效 |
⚠️ 重要安全提醒: robots.txt 是公開檔案(任何人都可以存取
hkseostore.com.hk/robots.txt)。如果你有真正敏感的內容需要保護,請使用密碼驗證或 IP 限制,而不是 robots.txt。在 robots.txt 中列出敏感目錄等於告訴攻擊者「這裡有好東西」。香港合規補充: 唔少香港公司會將內部文件(員工手冊、客戶名單、報價單 PDF)放上網,誤以為 robots.txt 擋住就「睇唔到」。呢個做法同時有 PDPO《個人資料(私隱)條例》 風險——如果入面載有個人資料,公開路徑本身就已經係問題。敏感資料請用登入驗證,唔好靠 robots.txt。
robots.txt 常見錯誤與陷阱
錯誤 1:用 Disallow 阻止索引
# 錯誤示範 — 這樣不會阻止頁面被索引!
User-agent: *
Disallow: /secret-page.html
如果 /secret-page.html 被其他網站(例如 LIHKG 連登或者 Facebook 社團有人貼條 link)連結,Google 仍可能把它索引(雖然爬蟲不會爬取,但可能從外部連結得知此頁面存在)。
正確做法: 在該頁面加上 <meta name="robots" content="noindex">
錯誤 2:意外阻止了必要資源
# 危險:阻止了 CSS 和 JS 檔案!
User-agent: *
Disallow: /assets/
Google 需要讀取 CSS 和 JS 來正確渲染頁面。如果阻止了這些資源,可能導致頁面渲染不完整,影響排名。
正確做法: 明確指定禁止的目錄,不要過度使用泛規則
錯誤 3:忘記 Allow 的優先級
User-agent: *
Disallow: /blog/
Allow: /blog/featured/
Allow 和 Disallow 的優先級取決於規則的具體程度(更具體的路徑優先),而不是指令的先後順序。上述範例中 /blog/featured/ 會被允許,因為它比 /blog/ 更具體。
錯誤 4:robots.txt 漏掉 Sitemap 指定
雖然不影響爬取行為,但指定 Sitemap 位置是最佳實踐,讓所有爬蟲(不只是手動提交對象)都能發現你的 Sitemap。
香港做法: 香港網站除咗 Google Search Console,記得同時去 Bing Webmaster Tools 提交 Sitemap。因為 ChatGPT 搜尋同 Microsoft Copilot 都係用 Bing 嘅索引,而 Yahoo 香港(hk.yahoo.com)嘅搜尋結果亦嚟自 Bing。交一次 Sitemap,三個入口都受惠。
測試與驗證 robots.txt
Google Search Console 測試工具
- 前往 Search Console → 設定 → robots.txt 測試工具
- 輸入 URL 測試是否被正確阻止或允許
- 發現語法錯誤時會有提示
手動測試
直接在瀏覽器輸入 https://yourdomain.com.hk/robots.txt 查看原始檔案
常見語法檢查項目
| 檢查項目 | 正確做法 |
|---|---|
| 編碼格式 | 必須是 UTF-8(香港繁中網站尤其要留意,唔好用 Big5 存檔) |
| 行尾符號 | 使用 LF(Unix 格式),避免 CRLF 不一致 |
| 空行 | 每個 User-agent 區塊之間用空行分隔 |
| 路徑格式 | 路徑從根目錄開始計算,無須完整 URL |
| 大小寫 | 路徑區分大小寫 |
2026 年 robots.txt 新趨勢:AI 爬蟲管理
隨著 AI 訓練資料爬蟲的增長,越來越多的網站開始在 robots.txt 中專門針對 AI 爬蟲:
# 阻止主要 AI 訓練爬蟲
User-agent: GPTBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: anthropic-ai
Disallow: /

User-agent: Google-Extended
Disallow: /
Google-Extended是用於控制內容是否被用於訓練 Google 的 AI 模型(如 Gemini)的專用爬蟲標識。
香港 AI 搜尋(GEO)視角:唔好一刀切擋晒
香港用家越嚟越多用 ChatGPT、Gemini、Perplexity、Microsoft Copilot、Google AI Overviews / AI Mode 搵嘢(例如「旺角邊間補習社好」「香港網店平台邊隻好」)。如果你一刀切 Disallow: / 擋晒所有 AI 爬蟲,後果係:AI 唔會引用你,變相喺 AI 搜尋入面消失。
所以要分清楚兩類爬蟲:
| 爬蟲類型 | 代表 | 建議做法(想做 AI 搜尋曝光) |
|---|---|---|
| 訓練型(餵畀模型學習) | GPTBot、CCBot、anthropic-ai、Google-Extended |
可視乎版權政策決定擋唔擋 |
| 搜尋 / 引用型(即時回答時引用你) | OAI-SearchBot、Claude-SearchBot、Claude-User、PerplexityBot、Googlebot |
✅ 建議容許,否則 AI 唔會引用你 |
| SEO 基礎爬蟲 | Googlebot、Bingbot |
✅ 必須容許 |
# 想保留 AI 搜尋曝光嘅寫法(只擋訓練,放行搜尋型)
User-agent: GPTBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: *
Disallow: /private/
Sitemap: https://www.hkseostore.com.hk/sitemap.xml
總結檢查清單
| 任務 | 說明 |
|---|---|
| ☐ 確認 robots.txt 存在於根目錄 | https://yourdomain.com.hk/robots.txt |
| ☐ 禁止爬取後台和無意義頁面 | /admin、/wp-admin、搜尋結果頁等 |
| ☐ 不要用 robots.txt 阻止索引 | 改用 Meta Robots noindex |
| ☐ 不要阻止 CSS / JS 資源 | Google 需要它們來渲染頁面 |
| ☐ 指定 Sitemap 位置 | 在 robots.txt 中加入 Sitemap 指令 |
| ☐ 同時向 Bing Webmaster Tools 提交 Sitemap | 覆蓋 Bing + Yahoo 香港 + ChatGPT / Copilot |
| ☐ 分開處理 AI 訓練爬蟲與 AI 搜尋爬蟲 | 擋 GPTBot,但要放行 OAI-SearchBot / PerplexityBot |
| ☐ 敏感資料唔好靠 robots.txt | 用密碼驗證;涉及個人資料要符合 PDPO |
| ☐ 用 Search Console 測試 | 定期驗證 robots.txt 規則正確 |
| ☐ 確認開發/測試環境已阻止 | Staging 環境設定 Disallow: / + Basic Auth |
| ☐ 需要 noindex 的頁面設定 Meta Robots | 而非依賴 robots.txt |
| ← 第 28 章:Sitemap 製作與提交 | 回索引 | 第 30 章:Canonical 標記與重複內容處理 → |