Crawl Budget 爬取預算優化
Crawl Budget(爬取預算) 是 Googlebot 在你的網站上,每天願意爬取的 URL 數量上限。它不是一個固定數字,而是由兩個因素決定的動態配額。
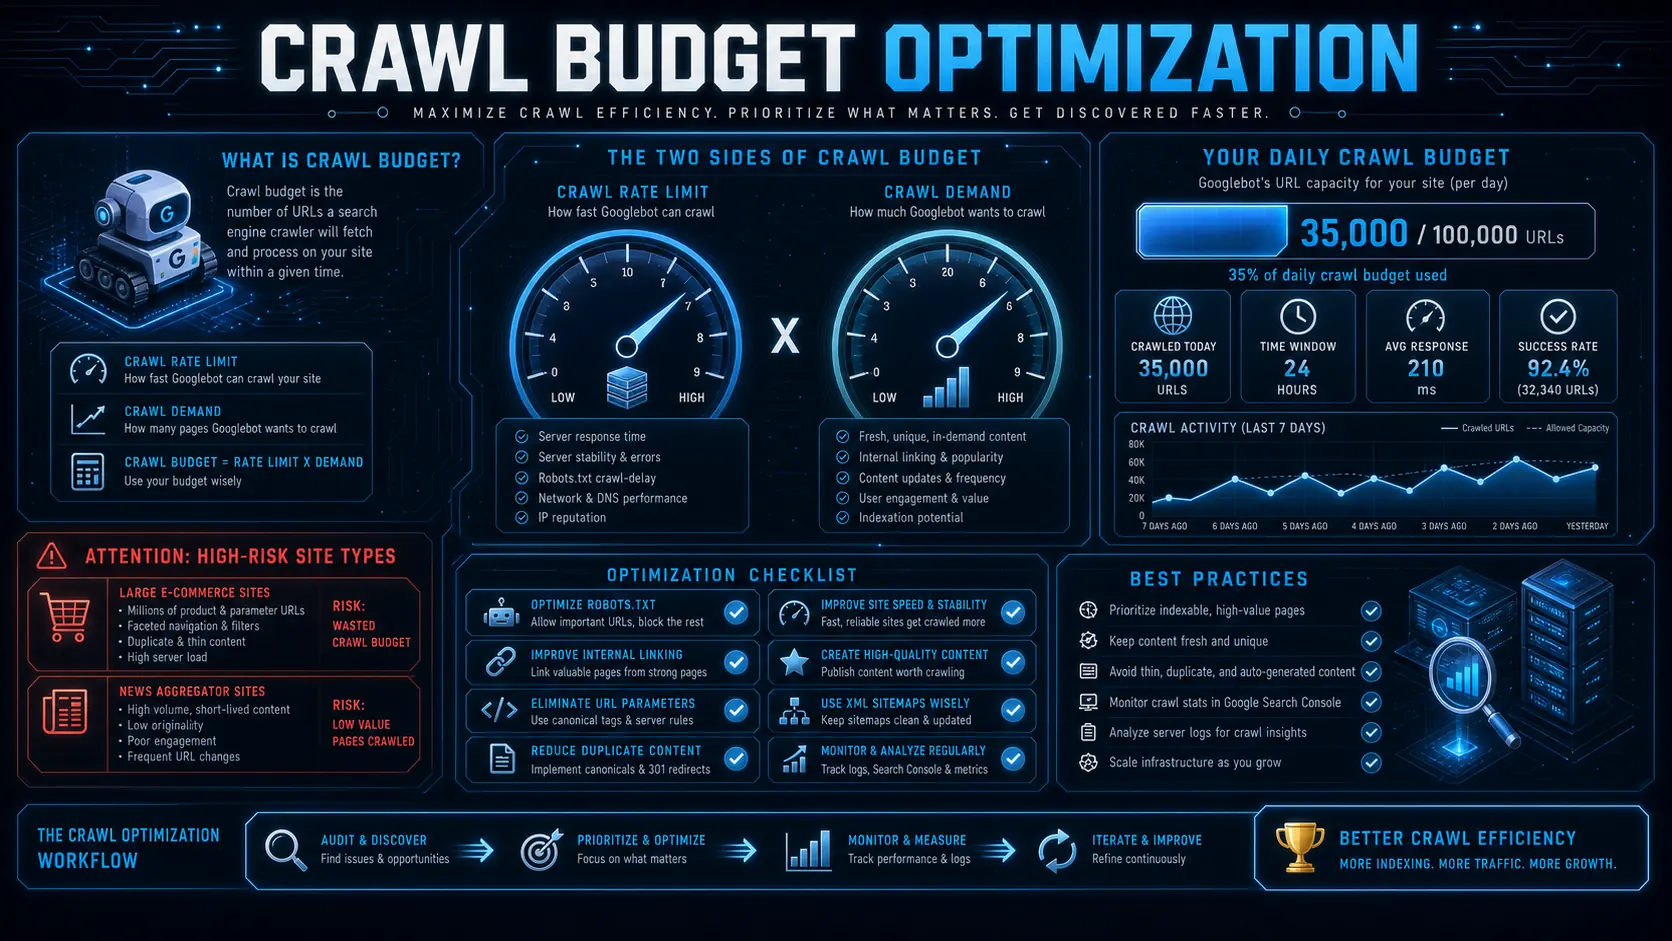
什麼是 Crawl Budget?
Crawl Budget(爬取預算) 是 Googlebot 在你的網站上,每天願意爬取的 URL 數量上限。它不是一個固定數字,而是由兩個因素決定的動態配額。
Crawl Budget = Crawl Rate Limit × Crawl Demand

  Crawl Rate Limit(爬取速率限制):
    Google 為了不影響你網站的伺服器效能,
    限制每秒爬取的請求數量。

  Crawl Demand(爬取需求):
    Google 根據你的網站內容價值、更新頻率、
    和網站整體品質,決定「值得花多少時間爬取」。
一句話: Google 不會爬取你的每一個頁面。它會優先爬取最有價值的頁面。如果你的網站有大量低品質頁面,它們會消耗你的 Crawl Budget,導致重要頁面久久不被爬取。
誰需要關心 Crawl Budget?
小網站(少於 1,000 個 URL):
  → 通常不需要擔心 Crawl Budget
  → Google 通常能在幾天內爬完所有頁面

中型網站(1,000 - 10,000 個 URL):
  → 開始需要留意
  → 確保不浪費預算在低價值頁面上

大型網站(10,000 - 100,000+ 個 URL):
  → Crawl Budget 是關鍵 SEO 因素
  → 不優化可能導致重要新內容數週不被索引

超大型網站(100 萬+ URL):
  → Crawl Budget 是日常 SEO 工作的核心
  → 需要專人管理和優化
典型的高風險網站
| 網站類型 | 香港常見例子 | 為什麼 Crawl Budget 是問題 |
|---|---|---|
| 電商網站 | 香港網店(HKTVmall 式大型目錄、時裝/美妝網店、Shopify / SHOPLINE 商店) | 篩選組合產生數萬 URL、分頁、商品變體 |
| 新聞媒體 | 香港01、經濟日報、明報、星島、東方、頭條日報 | 大量存檔頁面、分類頁面、標籤頁面 |
| 分類廣告 | Car1.hk(搵車)、DCFever 二手區、28Hse / 星之谷(樓盤) | 過期的廣告頁面仍然存在 |
| 論壇 | LIHKG(連登)、Discuss.com.hk、Uwants、高登 | 大量低內容頁面、會員頁面、重複討論 |
| 房地產 | 中原、美聯、利嘉閣、28Hse | 已售出 / 已租出 / 下架的樓盤頁面仍然可訪問 |
| 餐飲 / 生活平台 | OpenRice(開飯喇)式目錄、預約平台 | 店舖頁 × 地區 × 菜式 × 評分組合產生大量近似 URL |
香港情境提示: 香港網站多數以
.hk/.com.hk或/zh-hk/子目錄營運,繁中、英文、簡中版本並存時,URL 數量會瞬間變成 2–3 倍。做 Crawl Budget 審計時,記得把三個語言版本一併計入,並確認 hreflang 指向的頁面冇被 robots.txt 封錯。
Crawl Budget 被浪費的常見原因
原因 1:Faceted Navigation(分面導航)URL 爆炸
香港網店典型問題(例如一間旺角時裝網店,價錢以 HK$ 計):

  一個商品分類(女裝波鞋)+ 5 種顏色 + 5 種尺碼
   + 3 個價格範圍(HK$300-600 / HK$600-1,000 / HK$1,000 以上)=
   1 × 5 × 5 × 3 = 75 種組合 URL

  每個組合都是一個可爬取的 URL!
  Googlebot 花時間爬取 /shoes/?color=red&size=9&price=hkd600-1000
  而不是爬取你今季新上架的商品頁面。

  再加上地區篩選(門市自取:尖沙咀 / 銅鑼灣 / 沙田 / 將軍澳)
  → URL 數量再乘 4 倍。
原因 2:低品質頁面
低品質頁面消耗 Crawl Budget 的典型:

  → 內容少於 200 字的頁面(例如只得一句「銅鑼灣分店」的門市頁)
  → 自動生成的頁面(例如:標籤頁面)
  → 沒有獨特價值的分類/存檔頁面
  → 搜尋結果頁面(內部搜尋功能產生的 URL)
  → 重複內容頁面(例如:印刷版本、PDF 版本)
  → 同一篇文章的繁中 / 英文 / 簡中版本未做好 hreflang,被當成重複內容
  → 18 區地區頁(中西區、觀塘、元朗……)內容只差地區名,其餘完全一樣
原因 3:無限空間(Infinite Spaces)
什麼是無限空間?

  日曆頁面 → /events/2026/01/01, /events/2026/01/02, ...
  → 無窮無盡的 URL!
  (香港例子:演唱會 / 展覽 / 會議日程頁、
    OpenRice 式訂枱時間頁、補習社時間表)

  搜尋過濾功能 → 每個搜尋詞產生一個 URL
  → 理論上無限的 URL 數量
  (香港例子:樓盤搜尋「沙田 兩房 HK$600 萬以下」、
    搵車頁「HK$10 萬內 七座」)

Googlebot 一旦進入這些「兔子洞」,
會浪費大量 Crawl Budget。
原因 4:伺服器回應慢
如果 Googlebot 爬取你的頁面時經常遇到:
  → 500 錯誤(伺服器錯誤)
  → 漫長的回應時間(> 2 秒)
  → 超時(Timeout)

Google 會自動降低你的 Crawl Rate Limit,
因為它認為你的伺服器無法承受更高的爬取頻率。
Crawl Budget 優化策略
策略 1:阻止低價值 URL 被爬取
使用 robots.txt
# 阻止內部搜尋結果頁面
Disallow: /search/

# 阻止篩選參數
Disallow: /*?color=*
Disallow: /*?size=*
Disallow: /*?sort=*

# 阻止某些存檔頁面(如適用)
Disallow: /tag/

⚠️ 注意:
  robots.txt 阻止爬取,但不阻止索引(如果 Google 從其他來源發現該 URL)
  如果需要阻止索引,使用 meta robots noindex
使用 Meta Robots Noindex
<!-- 在低價值頁面的 <head> 中 -->
<meta name="robots" content="noindex, follow" />

<!-- noindex = 不要索引這個頁面 -->
<!-- follow = 但可以追蹤頁面上的連結 -->
策略 2:優化網站速度
速度直接影響 Crawl Rate Limit:

  頁面載入速度 200ms vs 2,000ms
  → Google 在相同時間內可以爬取 10 倍的頁面

優化方向:
  ✅ 使用 CDN(內容傳遞網路)
     → 香港網站特別受惠:Cloudflare / Akamai / AWS CloudFront
       都有香港或亞洲邊緣節點,Googlebot 由最近節點抓取,TTFB 明顯下降
     → 若主要客群喺香港,可選香港本地主機(HK colo)
       或 AWS ap-east-1(香港 region),延遲最低
  ✅ 優化伺服器回應時間(Time To First Byte < 200ms)
  ✅ 壓縮圖片和靜態資源
  ✅ 使用快取策略減少伺服器負載
  ✅ 確保主機方案足夠應付流量(平價共享主機經常是瓶頸,
     尤其本地促銷日如雙 11、新年大減價、演唱會開賣)
策略 3:保持網站「乾淨」
定期清理:

  ✅ 移除或 301 轉址的 404 頁面
     → 每個 404 都是一次被浪費的爬取

  ✅ 合併或刪除重複內容
     → 例如:/product/ 和 /product/?source=email 是同一頁

  ✅ 管理分頁的深度
     → 如果一個分類有 200 頁分頁,第 180-200 頁的內容可能不值得被頻繁爬取

  ✅ 修剪過時/低價值的內容(Content Pruning)
     → 如果某個頁面從來沒有流量、沒有反向連結,考慮刪除或 301 轉址
策略 4:優化 Sitemap
Sitemap 是你的 Crawl Budget 使用說明書:

  ✅ 只包含你想被索引的頁面(不要包含 noindex 頁面)
  ✅ 使用 <lastmod> 標記頁面最後更新時間
     → Google 可以優先爬取最近更新的頁面
  ✅ 使用 <priority> 和 <changefreq>(雖然 Google 不完全遵循)
  ✅ 將 Sitemap 拆分為多個子 Sitemap(大網站)
     → 例如:sitemap-products.xml、sitemap-blog.xml
  ✅ 在 robots.txt 中引用 Sitemap

範例 robots.txt(香港網店 .hk 域名):
  Sitemap: https://www.yoursite.hk/sitemap_index.xml
香港提示: 記得同時喺 Bing Webmaster Tools 提交 Sitemap。香港 Bing 份額約 3–5%(Yahoo 香港搜尋亦用 Bing 技術),而且 ChatGPT 搜尋與 Microsoft Copilot 大量依賴 Bing 索引——AI 時代唔可以只交 Google。
策略 5:內部連結結構優化
Google 通過內部連結發現新頁面:

  → 確保重要頁面在網站導航中(距首頁 3 次點擊內)
     (例如:首頁 → 服務 →「中環美容療程」)
  → 不要讓重要內容深埋在 /category/subcategory/subsubcategory/.../
  → 使用麵包屑(Breadcrumbs)導航
     (香港常見:首頁 > 九龍 > 油尖旺 > 尖沙咀 > 餐廳)
  → HTML Sitemap 頁面(人工可讀的網站地圖頁面)可以幫助 Google 發現頁面
  → 確保分頁連結使用 <a href> 而不是 JavaScript
監控 Crawl Budget
Google Search Console — Crawl Stats 報告
Search Console → 設定 → 爬取統計資料

可以查看:
  → 每天 Googlebot 爬取多少頁面
  → 爬取下載的數據量(KB/day)
  → 平均回應時間
  → 爬取需求變化的趨勢

值得留意的模式:
  ⚠️ 爬取量突然下降 → 可能伺服器有問題或網站被懲罰
  ⚠️ 爬取量一直偏低 → 可能需要優化 Crawl Demand
  ⚠️ 回應時間上升 → 伺服器效能需要改善
Log File Analysis(日誌分析)
進階做法:分析伺服器的存取日誌(access logs),了解 Googlebot 的實際行為。
日誌分析可以回答的問題:

  → Googlebot 最常爬取哪些頁面?
  → Googlebot 花了多少時間在低價值頁面上?
  → Googlebot 是否爬取了你不希望它爬取的 URL?
  → Googlebot 多久來一次?爬取頻率是否有變化?
  → 是否有頁面 Googlebot 應該爬取但從未爬取過?

推薦工具:
  → Screaming Frog Log File Analyzer
  → Botify(企業級)
  → OnCrawl
  → Splunk(自訂方案)
大型網站的 Crawl Budget 優化路線圖
第一步:審計(第 1 週)
☐ 使用 Screaming Frog 爬取整個網站,了解 URL 總數
☐ 在 Search Console 查看 Crawl Stats,了解現狀
☐ 列出所有低價值 URL 類型(搜尋頁面、篩選頁面、存檔等)
☐ 檢查有多少頁面被 noindex 但仍然被爬取
第二步:阻止浪費(第 2-3 週)
☐ 在 robots.txt 中阻止明確的低價值 URL 模式
☐ 對無法在 robots.txt 阻止的低價值頁面,加入 noindex 標籤
☐ 優化 Faceted Navigation(限制可爬取的篩選組合)
☐ 處理無限空間:使用 robots.txt 或規範化
第三步:優化 Sitemap(第 3-4 週)
☐ 清理 Sitemap:移除被 noindex 的頁面、移除 404 頁面
☐ 加入 <lastmod> 數據
☐ 拆分為多個子 Sitemap(如果網站較大)
☐ 在 robots.txt 中確認 Sitemap 引用正確
第四步:提升效率(持續)
☐ 優化伺服器回應時間
☐ 設置 CDN
☐ 優化內部連結結構
☐ 定期進行 Content Pruning
☐ 監控和調整
Crawl Budget 常見問題
Q1:Google 一天會爬取我的網站幾次?
答案:沒有固定答案。取決於:

  → 你的網站規模
  → Google 對你網站的「信任度」和權威度
  → 你的內容更新頻率(新聞網站 vs 靜態網站)
  → 你的伺服器效能
  → 你的 Crawl Budget 管理狀況

查看 Search Console → 爬取統計資料,了解你的實際數據。
Q2:noindex 頁面會消耗 Crawl Budget 嗎?
答案:會。雖然被 noindex 的頁面不會進入索引,
但 Googlebot 仍然需要先爬取該頁面才能看到 noindex 標籤。

優化策略:
  → 對於可以預先知道的低價值 URL,使用 robots.txt 阻止爬取
  → 對於需要 Google 看到 noindex 標籤的頁面,
    確保只在必要時才保留
  → 長遠來說,noindex 頁面的爬取頻率會自然降低
Q3:CDN 會影響 Crawl Budget 嗎?
答案:正面影響!

  CDN 幫助:
  ✅ 減少伺服器負載 → Google 可以增加 Crawl Rate
  ✅ 加快回應時間 → 相同時間內可以爬取更多頁面
  ✅ 全球節點 → Googlebot 從最近的節點爬取,速度更快
     (香港網站應確認 CDN 有啟用香港 / 亞洲 PoP)

  但注意:確保 CDN 不會阻擋 Googlebot!
  ⚠️ 常見錯誤:CDN / WAF 的地理封鎖(geo-blocking)或
     保安規則把 Googlebot(主要來自美國 IP)擋掉,
     令香港網站「自己封咗自己」。
     同時記得放行 AI 爬蟲(GPTBot、OAI-SearchBot、ClaudeBot、
     PerplexityBot、Google-Extended),做法同全球一致。

  驗證方法:Search Console → 網址檢查 →「即時測試」,
  或用 DNS / IP 反查確認 Googlebot 真身未被防火牆誤擋。

  香港用家常用 Cloudflare:留意 Bot Fight Mode /
  Managed Rules 有機會誤傷爬蟲,建議加白名單規則。
總結檢查清單
審計階段
| 任務 | 說明 |
|---|---|
| ☐ 確認網站的 URL 總數 | 使用 Screaming Frog 爬取 |
| ☐ 查看 Search Console Crawl Stats | 了解每日爬取量 |
| ☐ 識別低價值 URL 模式 | 搜尋頁面、篩選、存檔等 |
| ☐ 檢查伺服器回應時間 | 目標 < 200ms |
優化階段
| 任務 | 說明 |
|---|---|
| ☐ robots.txt 阻止低價值路徑 | /search/、篩選參數等 |
| ☐ 低價值頁面加入 noindex | 不能透過 robots.txt 處理的頁面 |
| ☐ 清理 Sitemap | 只包含值得索引的頁面 |
| ☐ 加入 |
幫助 Google 優先爬取更新內容 |
| ☐ 優化網站速度 | CDN、快取、伺服器升級 |
| ☐ 處理 Faceted Navigation | 限制可爬取的篩選組合 |
| ☐ 內部連結優化 | 確認重要頁面在 3 次點擊內 |
| ☐ 定期 Content Pruning | 清除過時和低品質內容 |
| ← 第 55 章:分頁 SEO 與無限滾動策略 | 回索引 | 第 57 章:網站搬遷與域名遷移 SEO SOP → |