JavaScript SEO 與 Log File 分析
在 SPA(Single Page Application)和前端框架(React、Vue、Angular)日益普及的時代,JavaScript SEO 成為技術 SEO 中最具挑戰性的領域。核心問題很簡單:
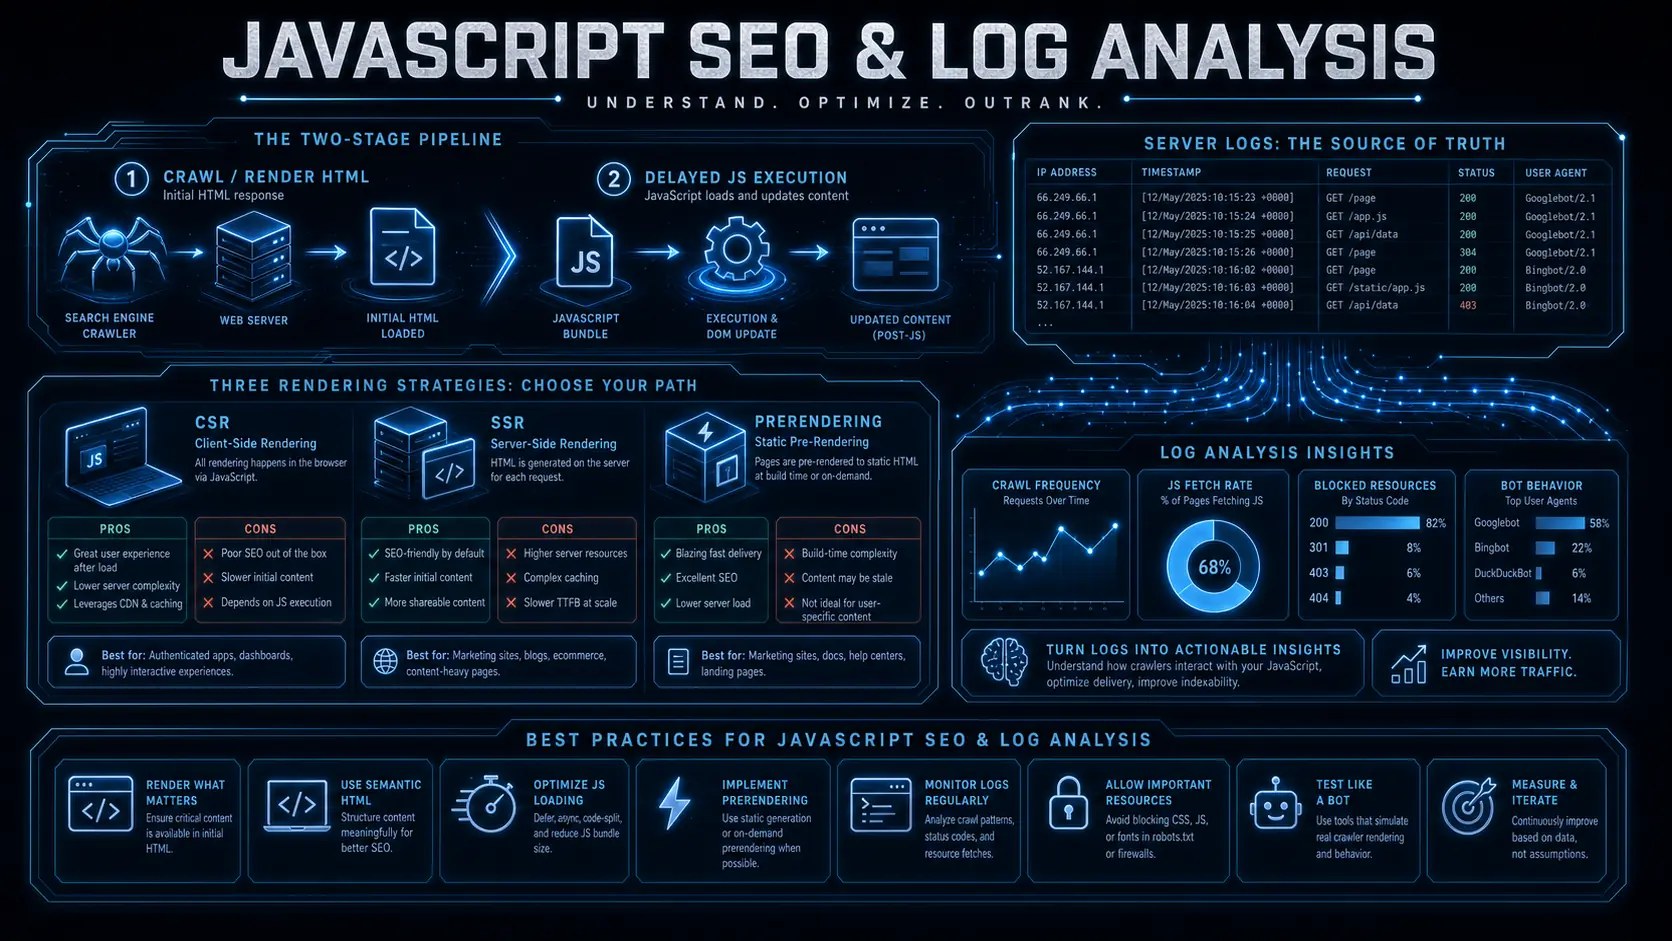
JavaScript SEO 的重要性
在 SPA(Single Page Application)和前端框架(React、Vue、Angular)日益普及的時代,JavaScript SEO 成為技術 SEO 中最具挑戰性的領域。核心問題很簡單:
Google 能不能看到你的內容?
傳統網站:伺服器直接返回 HTML → Googlebot 直接讀取 ✅ JS 渲染網站:伺服器返回空的 HTML 框架 → 需要 JS 執行後才有內容 ⚠️
香港場景: 香港好多新興平台都用 React / Vue 起——餐廳訂枱平台、地產盤源搜尋(例如 28Hse 類型)、網店前台、活動售票網。呢啲網站最大嘅問題唔係「靚唔靚」,而係「Google 第一眼睇到嘅係一張白紙」。
Google 如何處理 JavaScript
Googlebot 的「兩階段」索引流程
第一階段:爬取與解析
  → Googlebot 讀取 HTML,提取連結和資源(CSS/JS)

第二階段:渲染(延遲執行)
  → 將 JS 檔案送去 Web Rendering Service(WRS)
  → 使用 Chromium 執行 JS
  → 讀取最終渲染後的 DOM
  → 提取內容和連結
關鍵問題: 第一階段和第二階段之間存在時間差。Google 可能在第一階段就開始索引,也可能幾天甚至幾週後才進行第二階段的 JS 渲染。
2026 年現狀: Google 的 JS 渲染能力已大幅提升,但仍不是即時的。對於時效性內容,完全依賴 JS 渲染有風險。
香港例子: 一間香港餐廳推出「週年限定 HK$188 晚市套餐」,活動只得兩星期。如果個優惠頁完全靠 JS 渲染,Google 可能喺活動完咗之後先「睇到」,白白錯過晒流量。時效性內容一定要 SSR / SSG。
三種渲染策略與 SEO 影響
1. CSR(Client-Side Rendering,用戶端渲染)
伺服器 → 空的 HTML(只有 <div id="root"></div>)→ 瀏覽器下載 JS → JS 執行 → 渲染內容
| 面向 | 評估 |
|---|---|
| SEO 友善度 | ❌ 有風險 |
| 首次載入速度 | ❌ 較慢(需先載入 JS) |
| 開發體驗 | ✅ 前後端分離,開發效率高 |
| Google 索引延遲 | ⚠️ 數天至數週 |
| 社群媒體爬蟲 | ❌ Facebook/Instagram/WhatsApp 預覽無法讀取 JS 內容 |
香港補充: 香港人極依賴 WhatsApp、Facebook Messenger、Instagram 分享連結。CSR 網站分享出嚟通常只會出個空白預覽圖,連 Open Graph 都讀唔到,間接影響點擊率。
2. SSR(Server-Side Rendering,伺服器端渲染)
伺服器 → 執行 JS → 生成完整 HTML → 回傳給瀏覽器
| 面向 | 評估 |
|---|---|
| SEO 友善度 | ✅ 最佳 |
| 首次載入速度 | ✅ 快速(直接回傳 HTML) |
| 伺服器負載 | ⚠️ 較高 |
| 開發複雜度 | ⚠️ 需要 Node.js 伺服器 |
| 框架支援 | Next.js、Nuxt.js、Remix、SvelteKit |
3. SSG(Static Site Generation,靜態網站生成)
建置階段 → 預先渲染所有頁面 → 輸出純 HTML 檔案 → 部署到 CDN
| 面向 | 評估 |
|---|---|
| SEO 友善度 | ✅ 最佳 |
| 載入速度 | ✅ 最快(純 HTML + CDN) |
| 動態內容 | ⚠️ 需在建置時決定,無法即時變更 |
| 框架支援 | Next.js、Gatsby、Astro、Hugo、11ty |
香港實務建議: 香港網站嘅目標客群主要喺本地,伺服器多數放喺香港或新加坡數據中心,本身 TTFB 已經好快。若加上 Cloudflare CDN(香港有節點)做 SSG 快取,LCP 通常可以穩定喺 1.5 秒內——呢個組合喺香港市場性價比最高。
JavaScript SEO 實戰檢查
檢查 1:Google 看到的 vs 使用者看到的
使用以下工具對比:
| 工具 | 用途 |
|---|---|
| Google Search Console → URL 檢查 | 查看 Google 渲染後的「螢幕擷圖」 |
| Rich Results Test | 查看 Google 能否讀取結構化資料 |
| View Page Source (右鍵 → 檢視網頁原始碼) | 查看「第一階段」Google 讀到的 HTML |
| Inspect Element (開發者工具) | 查看 JS 渲染後的完整 DOM |
| Chrome DevTools → JavaScript 停用測試 | 模擬 Googlebot 第一階段爬取 |
核心檢查清單
☐ 關閉 JS 後,頁面主要內容是否存在?
☐ 關閉 JS 後,導覽連結是否可用?
☐ 關閉 JS 後,<title> 和 <meta description> 是否存在?
☐ 關閉 JS 後,canonical 標籤是否存在?
☐ 關閉 JS 後,結構化資料是否存在?
☐ 關閉 JS 後,<h1> 標題是否存在?
☐ 關閉 JS 後,內部連結是否可被發現?
☐ 關閉 JS 後,Open Graph(og:image / og:title)是否存在?(影響 WhatsApp / FB 分享預覽)
實用方法: 在 Chrome 中安裝「Web Developer」擴充 → Disable JavaScript → 重新載入頁面,觀察內容是否仍然存在。
JavaScript 框架 SEO 最佳實踐
Next.js(React)
// 在需要 SEO 的頁面使用 SSR 或 SSG
export async function getServerSideProps(context) {
  // SSR: 每次請求都在伺服器端渲染
  const data = await fetch(`https://api.hkseostore.com.hk/page/${context.params.id}`);
  return { props: { data } };
}

export async function getStaticProps() {
  // SSG: 建置時生成靜態 HTML
  const data = await fetch('https://api.hkseostore.com.hk/pages');
  return { props: { data } };
}
Nuxt.js(Vue)
// nuxt.config.js
export default {
  ssr: true,  // 啟用 SSR
  target: 'server',  // 或 'static' 用於 SSG
}
通用建議
| 做法 | 說明 |
|---|---|
動態 <title> 和 meta |
使用 react-helmet(React)或 vue-meta(Vue)確保每個頁面的 meta 標籤正確;香港雙語網站記得 <html lang="zh-HK"> |
| 歷史路由模式 | 使用 History API(而非 hash /#/),確保 URL 乾淨 |
| Lazy Loading 謹慎使用 | 確保主要內容不在 lazy load 中 |
避免 window / document 直接呼叫 |
SSR 環境中沒有這些物件,會報錯 |
| 關鍵 CSS 內聯 | 確保首屏樣式直接內嵌,不依賴 JS 下載 |
| Open Graph 伺服器端輸出 | 香港用戶大量經 WhatsApp / Facebook 分享,og 標籤要喺 HTML 入面 |
Log File 分析入門
什麼是 Log File?
伺服器日誌檔記錄了每一次被存取的請求,包括誰訪問了什麼、什麼時候、結果如何。對於 SEO 來說,最重要的是 Googlebot 的爬取紀錄。
# Apache / Nginx 典型的 Log 格式(注意香港時區 UTC+8)
66.249.66.1 - - [23/Jul/2026:14:30:00 +0800] "GET /blog/seo-guide HTTP/1.1" 200 15240 "-" "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"
香港提示: 好多香港網站嘅 server log 預設用 UTC / GMT,睇落會慢咗 8 個鐘。分析爬取時段(例如想知 Googlebot 係咪喺香港時間凌晨三點嚟爬)之前,記得先轉換時區,否則會誤判。
Log File 能回答的 SEO 問題
| 問題 | Log 提供的答案 |
|---|---|
| Googlebot 爬了哪些頁面?頻率多少? | 每個 URL 的爬取時間和頻率 |
| Googlebot 是否浪費時間在無意義頁面? | 爬取非重要頁面的比例 |
| 多少請求返回 404 / 500 等錯誤? | 每個狀態碼的請求數量和 URL |
| 哪個爬蟲最活躍? | 按 User-Agent 分類統計 |
| 靜態資源是否被大量爬取? | JS/CSS/圖片被 Googlebot 請求的頻率 |
| 是否有意外的爬蟲在大量請求? | 異常的爬蟲行為 |
香港要特別留意的爬蟲
除咗 Googlebot,香港網站嘅 log 入面常見嘅仲有:
| 爬蟲 | User-Agent 關鍵字 | 點解要留意 |
|---|---|---|
| Bingbot | Bingbot |
Yahoo 香港(hk.yahoo.com)搜尋結果用 Bing 索引;ChatGPT 搜尋、Copilot 都用 Bing |
| GPTBot / OAI-SearchBot | GPTBot、OAI-SearchBot |
ChatGPT 訓練 / 即時搜尋引用(GEO 關鍵) |
| ClaudeBot / Claude-SearchBot | ClaudeBot、Claude-User |
Anthropic 嘅 Claude |
| PerplexityBot | PerplexityBot |
Perplexity AI 搜尋 |
| Baiduspider | Baiduspider |
只有做內地 / 大灣區生意先需要理(香港本地唔係主戰場) |
| 360Spider / Sogou | 360Spider、Sogou web spider |
同上,內地市場專用 |
| Applebot | Applebot |
Siri 建議、Spotlight 搜尋(香港 iPhone 滲透率極高,唔好忽略) |
| Google-Extended | Google-Extended |
Gemini / AI Overviews 訓練用途 |
重點: 如果你發現
OAI-SearchBot或PerplexityBot從未出現喺 log,好可能係你喺 robots.txt 擋咗佢哋——咁 AI 搜尋就唔會引用你嘅內容(見第 29 章)。
Log File 分析的 SEO 價值
Googlebot 的爬取總量 = Crawl Budget

你應該確保:
- Googlebot 大部分時間在爬「重要頁面」
- Googlebot 沒有浪費時間在404、重定向、低品質頁面
- 重要新內容被快速發現和爬取
Log File 分析工具
免費工具
| 工具 | 說明 |
|---|---|
| Screaming Frog Log File Analyser | 最常用的 SEO Log 分析工具,支援視覺化報表 |
| Google Search Console | 查看「檢索統計資料」報告(簡單版 crawl stats) |
| ELK Stack(Elasticsearch + Logstash + Kibana) | 開源大數據 Log 分析平台 |
| GoAccess | 終端機即時 Log 分析工具 |
專業付費工具
| 工具 | 特點 |
|---|---|
| Botify | 企業級 Log 分析,結合爬取數據和 Log 數據 |
| Oncrawl | 整合 Log、爬取、排名數據的 SEO 平台 |
| Splunk | 大型企業的 Log 管理平台 |
實務建議: 對大多數網站來說,Screaming Frog Log File Analyser 已足夠。每年一次深度 Log 分析就能發現大量優化機會。
香港收費參考: Screaming Frog SEO Spider 授權約 HK$1,500/年(£129),Log File Analyser 免費版可處理較細嘅 log;大型網站先需要升級。
Log File 分析實戰流程
第一步:取得 Log 檔案
- 從主機面板(cPanel / Plesk)下載——香港本地寄存服務多數係 cPanel,通常喺「Raw Access Logs」或者「Metrics」度搵到
- 透過 SSH 存取
/var/log/nginx/access.log或/var/log/apache2/access.log - 使用 CDN 的話,Cloudflare / CloudFront 都有 Log 下載功能
- Cloudflare 免費版要開 Logpush(可推送到 R2 / S3)先攞到完整 log
第二步:過濾 Googlebot
# Linux 命令列過濾 Googlebot
grep "Googlebot" access.log > googlebot-requests.log

# 順便睇吓有冇 AI 搜尋爬蟲嚟過
grep -E "GPTBot|OAI-SearchBot|ClaudeBot|PerplexityBot|Bingbot|Applebot" access.log > ai-bots.log
驗證真偽: 記得用 reverse DNS 驗證(
host 66.249.66.1應該 resolve 去*.googlebot.com),因為有唔少假扮 Googlebot 嘅爬蟲。
第三步:分析爬取模式
- 哪些 URL 被爬取最多 / 最少?
- 哪些目錄 被過度爬取(例如搜尋結果頁、篩選頁)?
- 哪些重要頁面 長時間未被爬取?
- 新內容 被發現的速度如何?
- 錯誤回應(4xx/5xx)的比例?
第四步:制定優化行動
| 發現 | 行動 |
|---|---|
| Googlebot 浪費時間在搜尋結果頁 | robots.txt 阻止搜尋結果頁 |
| 重要產品頁很少被爬取 | 改善內部連結結構 |
| 大量 5xx 錯誤 | 修復伺服器效能問題(香港共享主機喺促銷期好易爆) |
| 圖片 URL 被大量爬取 | 確保圖片有正確的 <img> 標籤 |
| 新文章多天未被爬取 | 檢查 Sitemap 更新和內部連結 |
| AI 搜尋爬蟲從未出現 | 檢查 robots.txt 係咪擋咗佢哋 |
Crawl Budget 優化策略
Crawl Budget(爬取預算) = Google 每天願意爬取你網站的頁面數量。
影響 Crawl Budget 的因素
| 因素 | 說明 |
|---|---|
| 網站規模 | 小網站通常有充足的爬取預算 |
| 網站健康度 | 大量錯誤會降低 Google 的爬取意願 |
| 內容新鮮度 | 頻繁更新的網站獲得更多爬取預算 |
| 網站速度 | 回應越快的網站,Google 爬取效率越高 |
| 反向連結 | 更多高品質反向連結 → 更多爬取 |
優化清單
1. 確保重要頁面載入速度快(< 2 秒)
2. 消除低品質頁面(thin content、自動生成頁面)
3. 用 robots.txt 阻止無效 URL 空間(搜尋結果、篩選組合)
4. 使用正確的 HTTP 狀態碼(不要 soft 404)
5. 減少重定向鏈
6. 確保 Sitemap 準確且即時更新
7. 透過內部連結引導 Googlebot 到重要內容
8. 合併分散在多個 URL 的內容
9. 香港專屬:確保伺服器 / CDN 有香港或亞洲節點,降低 TTFB
10. 香港專屬:放行 AI 搜尋爬蟲(OAI-SearchBot、PerplexityBot 等)做 GEO
總結檢查清單
| 任務 | 說明 |
|---|---|
| ☐ 關閉 JS 後檢查頁面內容 | 確保主要內容在無 JS 環境中可見 |
| ☐ |